这份笔记是我学 Transformer 时记下来的,最早发在 CSDN 上。现在搬回自己的站点,顺手把顺序和数据流重新捋了一遍——结论没变,讲法顺了一些。
它不算教程,更像一份学习记录:先看整体,再把零件一个一个拆开。
先看整体:数据是怎么流过的
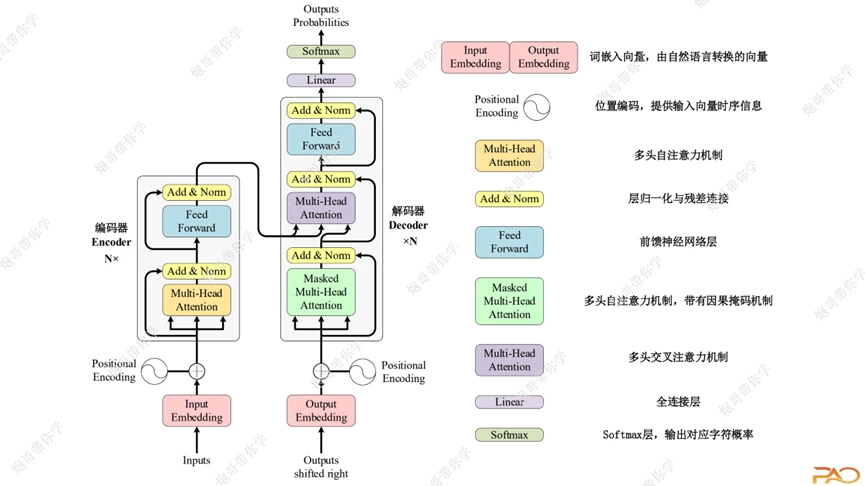
输入先经过词嵌入矩阵,与位置编码融合,然后进入多头注意力机制(Q、K、V),再经过层归一化与残差连接,到前馈神经网络,之后再一次层归一化与残差连接。到这里就是输入加上编码器(Encoder)的部分——编码器可以按同样的结构堆叠 N 层。
解码器这一侧,输入从 <start> 开始,同样先做词嵌入与位置编码,然后依次经过:
因果掩码注意力 → 层归一化 + 残差 → 交叉注意力 → 层归一化 + 残差 → 前馈神经网络 → 层归一化 + 残差 → 线性层 → softmax → output所以整个架构无非就是这几个模块,我们逐一搞懂即可。
大模型的认识
我们都用过很多大模型,会发现提问之后,它的输出并不是把整段话一次性给出来,而是像词语接龙一样,一个词一个词往外蹦。把大模型的基础学完,再回头看这个过程,对 AI 的理解会具体很多。
学大模型、学 Agent,我给自己列了三个要先回答的问题。
1. 神经网络是什么? 最基础的答案,它是学习的地基:x -> f(x) -> y。
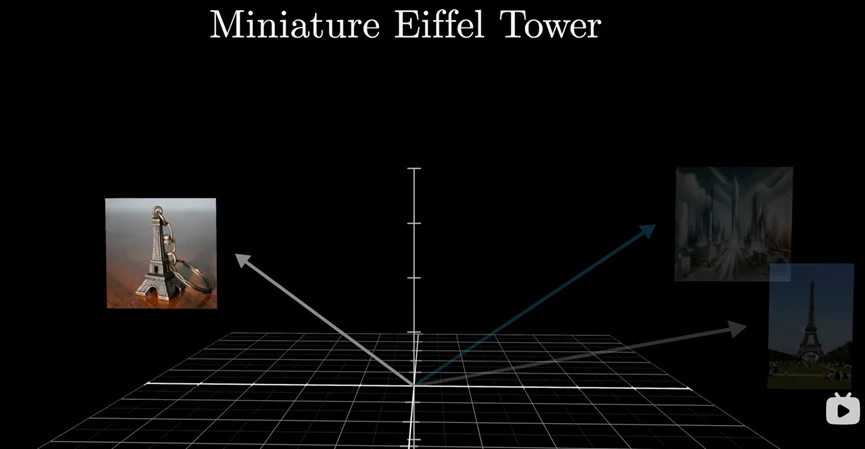
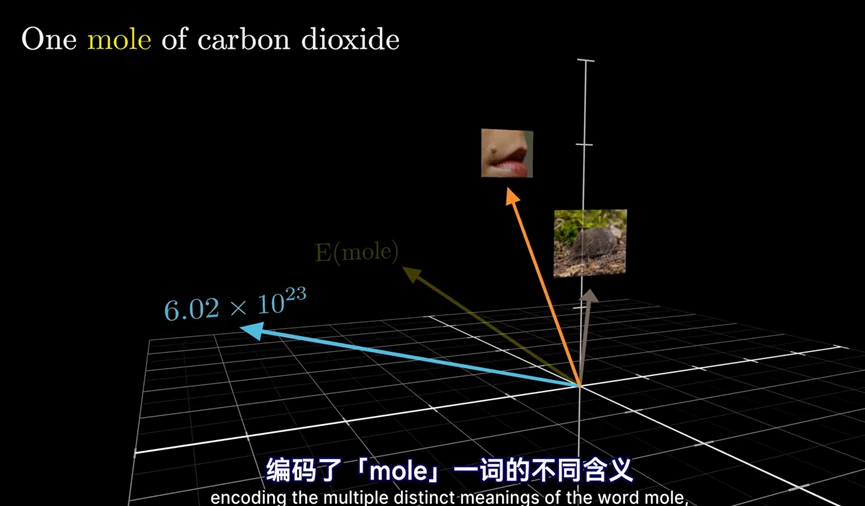
2. 注意力机制是什么? 对你的输入,我需要分配不同的注意力(也就是权重参数),让输出朝向你希望的样子。换成空间的角度看:一个词(token)会有很多向量方向,注意力就是把这个词转成符合当前语义的那个向量方向。
3. PyTorch 的架构? 记住这几个零件就够了:Tensor(张量)、Parameter(可优化参数,也就是初始化参数)、Model(模型)、Autograd(计算梯度)、Optimizer(优化参数)。
现在可以进入 Transformer 了。
模型组成
1. Token
我们需要先把语句拆成很多个词,这个词就叫 token。比如 I love you,这里是 3 个 token,先把它当成单词理解。
计算机不认识这些单词,所以还要转成计算机能识别的语言——向量。每个 token 里包含很多数值,这些数值我们很难直接看懂,但大致能表示词的语义、词性、位置等等复杂信息。同一个单词在不同语句里的向量是不同的。
2. 词嵌入矩阵
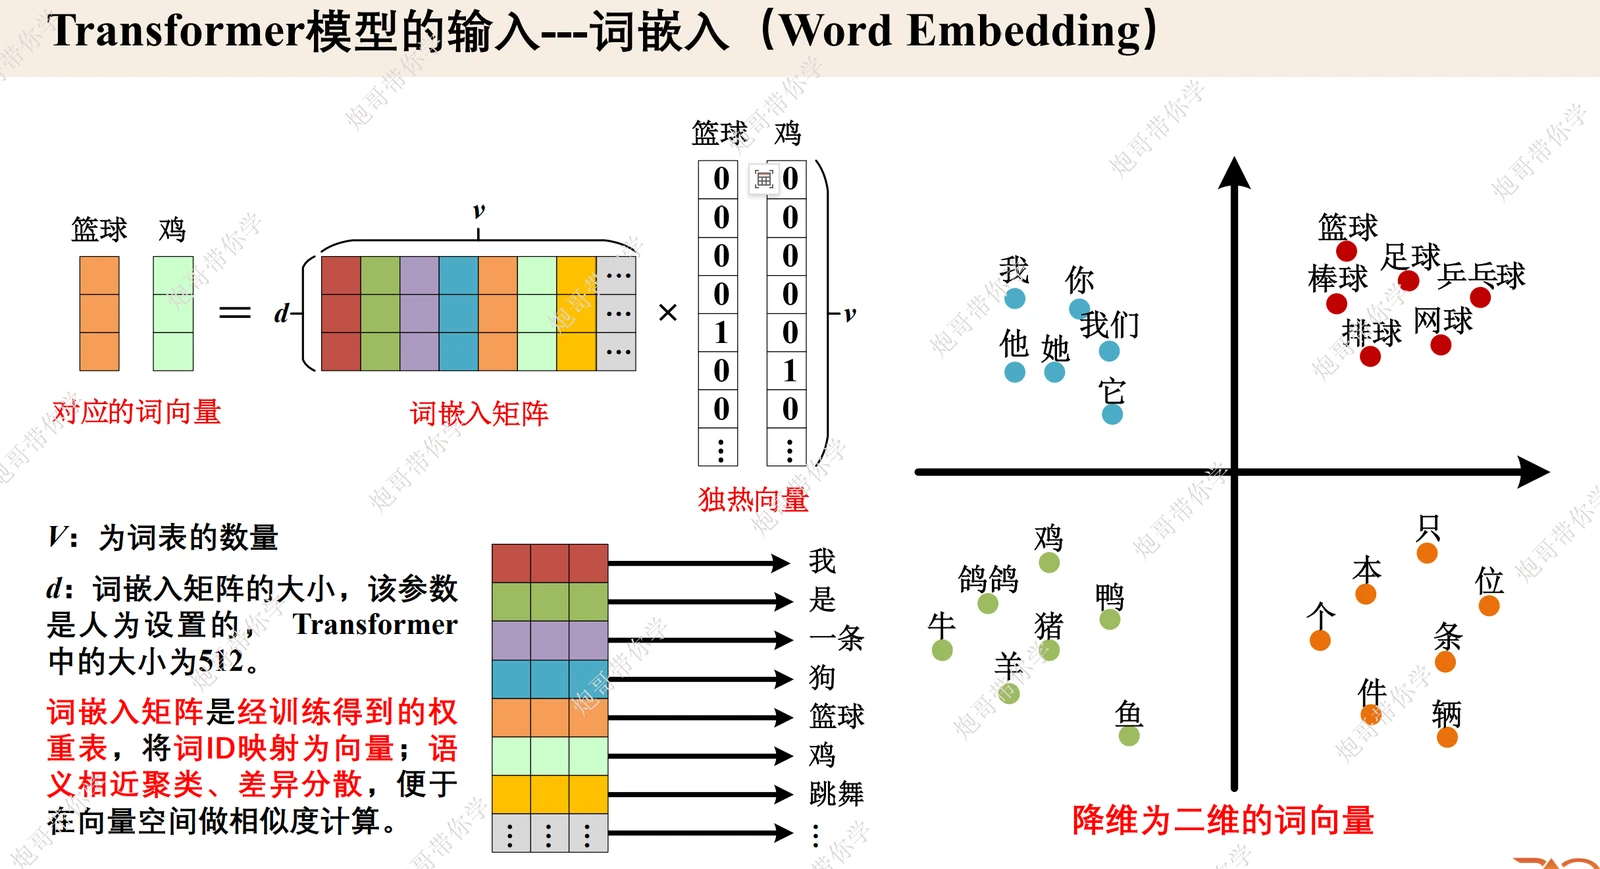
最初处理 token 时,用的是独热编码(0/1)。比如「我是一只狗」:
我 -> [1, 0, 0, 0, 0, …]是 -> [0, 1, 0, 0, 0, …]一 -> [0, 0, 1, 0, 0, …]问题很明显:维度很大,而每个向量只有一个位置是 1。所以引入词嵌入:通过词嵌入矩阵(一张训练得到的权重表),让语义相近的词聚在一起、差异大的词分散开,同时完成降维——用数值把自然语言区分开。
- 词向量维度
d一般为 512,包含 token 的基本语义信息,是模型训练中可调节的权重表。 V是词表数量,也就是 token 的数量。- 词嵌入矩阵是
d × V;单个 token 的独热向量是V × 1,相乘得到d × 1。整个句子的 token 组合起来就是V × d。
3. 位置编码
到这里数据其实已经处理好了,为什么还要再处理一次?因为我们面对的不是表格、图片这类数据,而是带有顺序、有语义逻辑的信息。比如「狗咬人」和「人咬狗」,词的位置不同,含义完全不同,所以需要一份信息来衡量这种性质。
Transformer 里的位置编码是一个和三角函数有关的公式,参数是词嵌入的维度 d 和当前 token 在序列中的位置 pos,最后与词嵌入矩阵逐项相加。
4. 注意力机制:Q、K、V
初始时 token 里只有自己的向量,但进入 Transformer 之后,在上下文的语义下,attention 会把向量移动到对应的语义位置上。
当我们预测下一个 token 时,依据是上一个 token 的嵌入向量;由于它已经包含了上下文的语义,它的参数量远大于单个 token 本身。
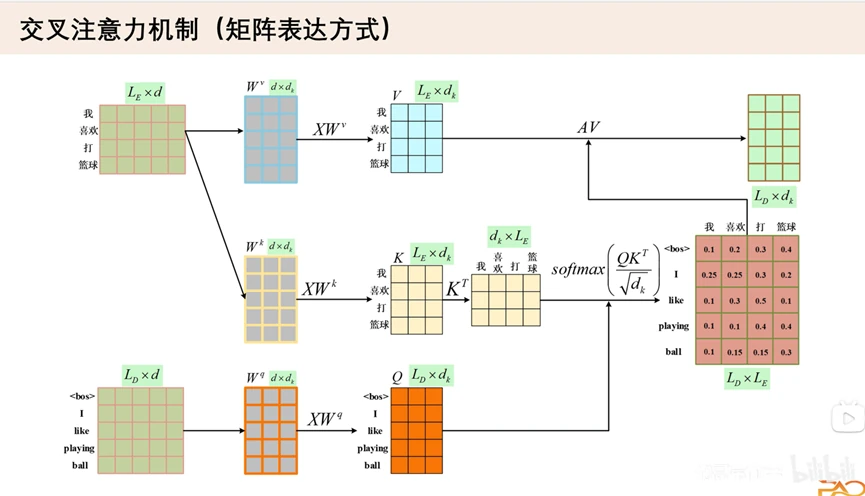
接下来是最重要的三个参数:Q、K、V。
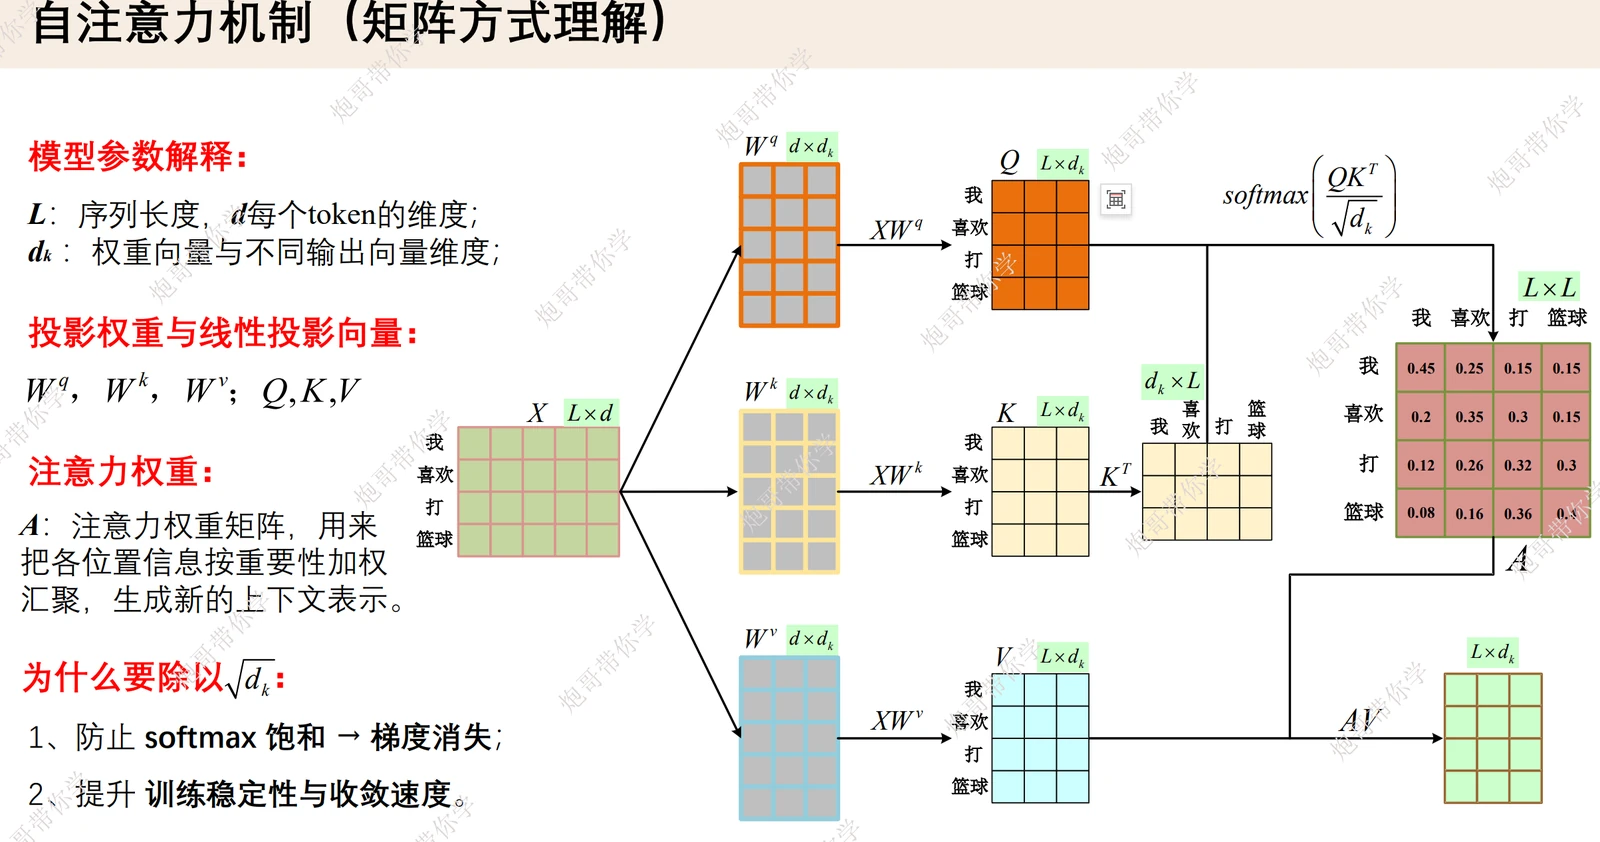
Q(Query):比如在一句英文里,名词会询问自己前面是否有形容词,这种询问被编码成另一种向量,就是 query。相当于每个词去提问自己的上下文信息。Q = Wq · E,其中 Wq 是模型学习的参数,Q 的维度远小于 E 的维度,相当于从高维降到低维。
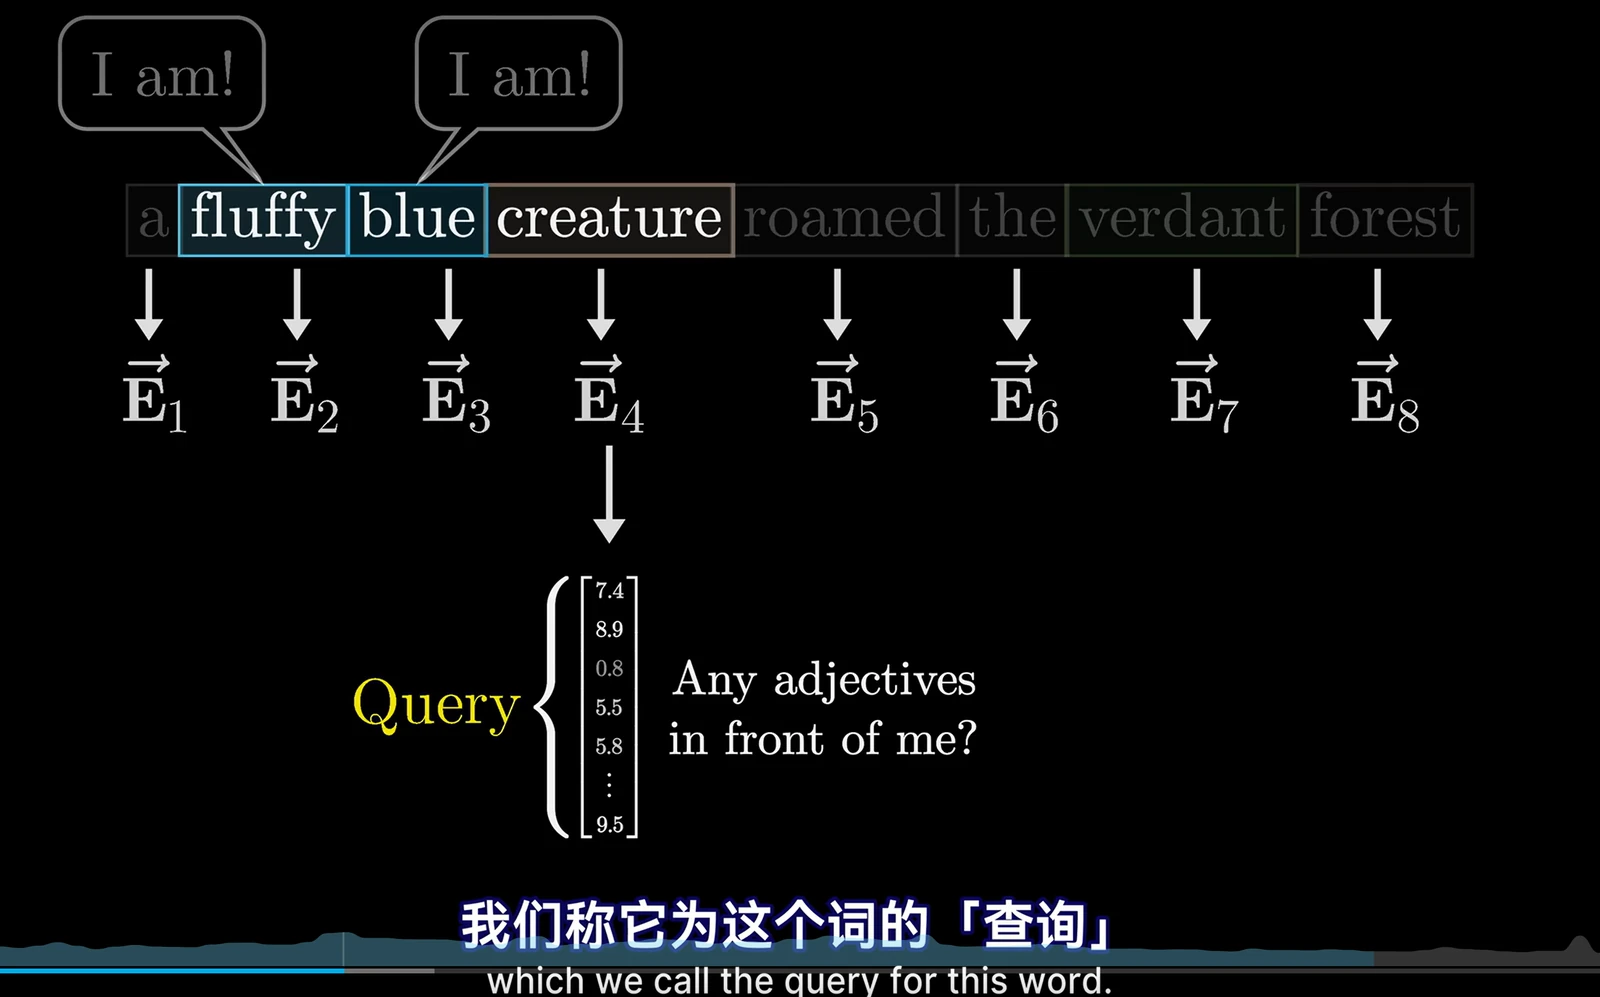
K(Key):如果前面确实有形容词,那么形容词的回答就成为 key。Wk 同样也是可学习的参数,K = Wk · E。所以当名词对形容词的查询真的存在时,相关性就大:Q 与 K 的点积大,查询与回答就对齐。
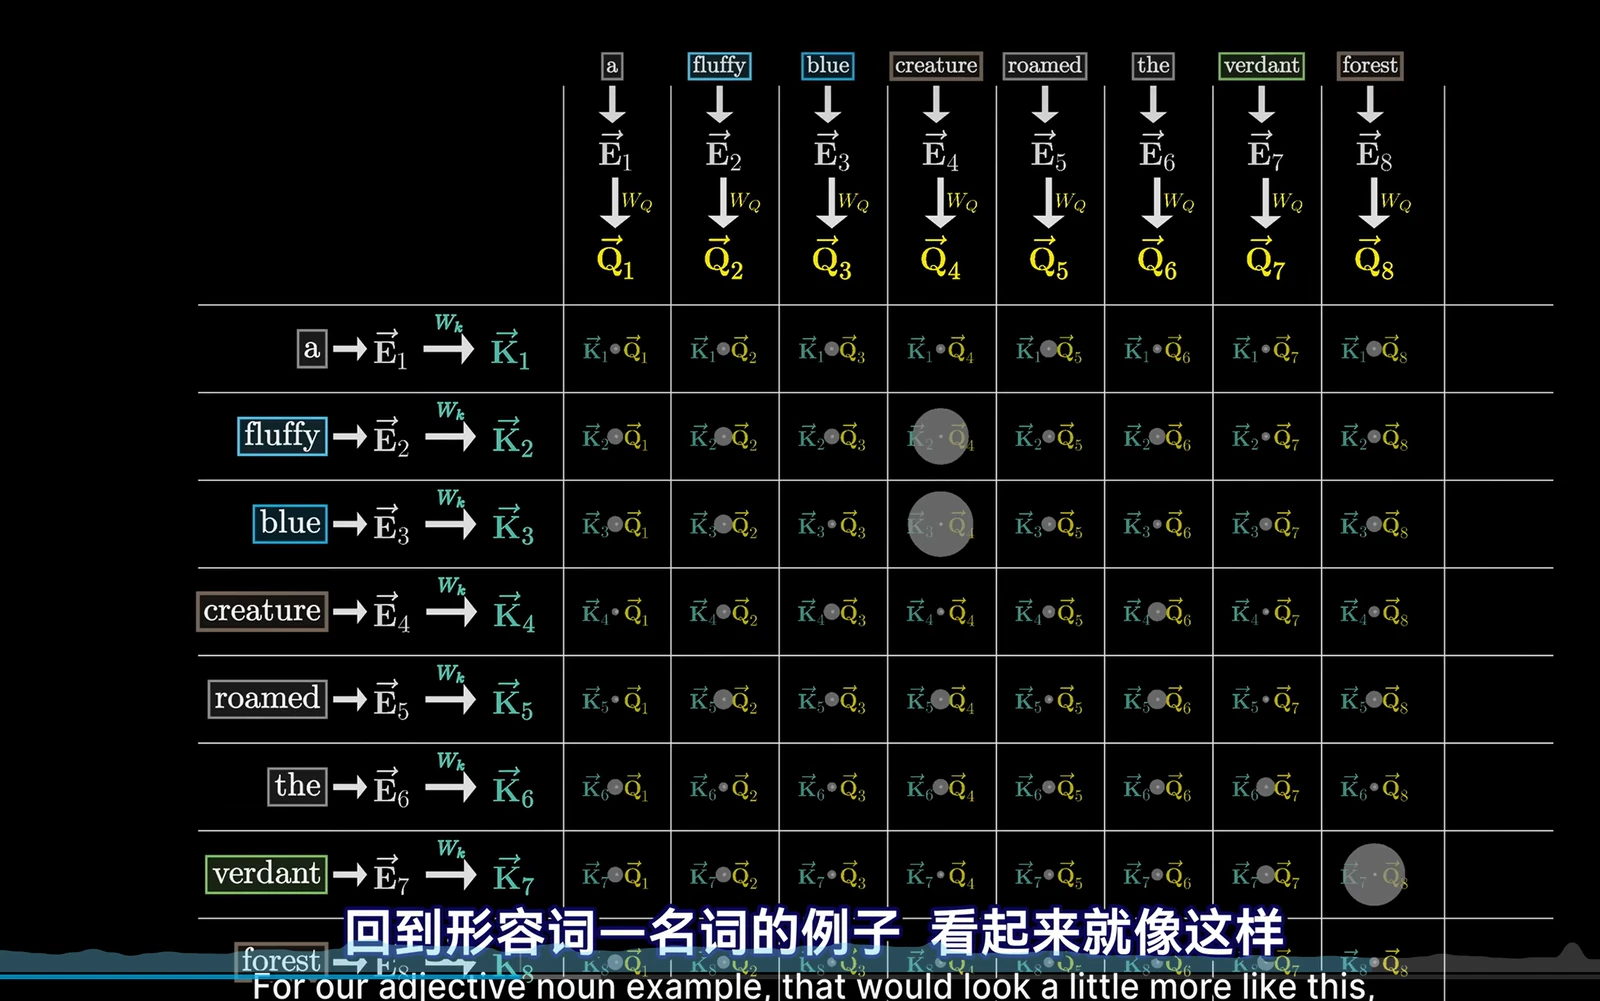
之后要得到概率,就经过 softmax;为了数值稳定,先除以维度的平方根。
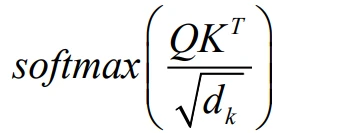
V(Value):如果要改变某一个词的含义,你需要加入的那个向量。
这里我可能解释得不太好,建议大家再从其他地方补充看看。上面讲的是自注意力机制;在机器翻译任务里还存在交叉注意力机制:一种语言的词对另一种语言的词提问、回答,这里不会用到掩码(后面会讲),因为不存在「偷看」问题。
5. 训练和推理
以翻译任务为例,输入是「我是一条狗」,labels 是 I am a dog。
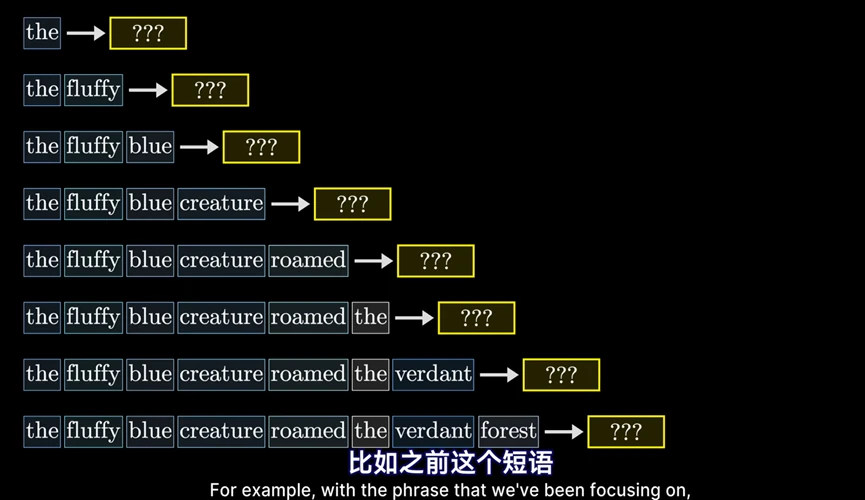
先讲推理过程:输入中文,经过编码器得到编码信息;解码器从 <start> 开始,把神经网络的运算与编码信息结合,得到概率最高的英文 I;再从 <start> I 出发得到 am;再从 <start> I am 出发得到 a……一直到 <end> 结束符。
所以它是把每一个输出和之前的输出一起作为输入,去推理得到下一个输出。
训练过程不太一样。首先模型会充分利用数据:同时预测多个 token,一个样本训练多次,并并行计算 loss,效率大大加快。
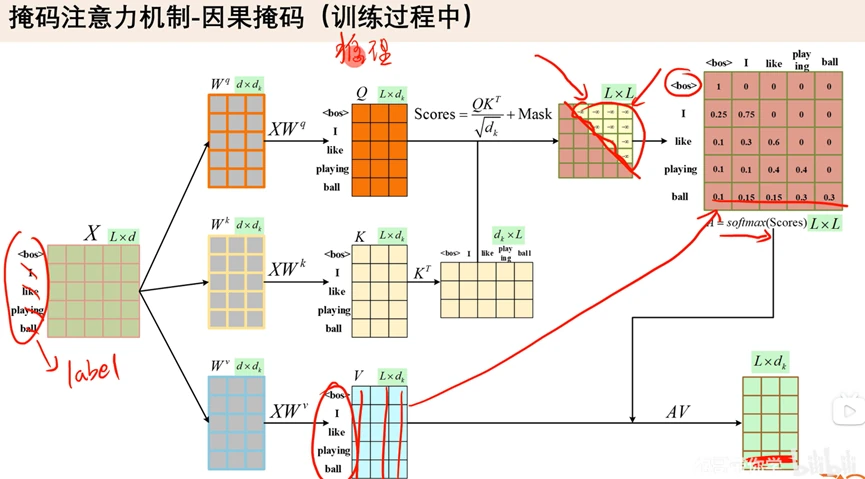
同时,我们需要让模型朝正确的方向训练。还是前面的翻译任务:如果模型第一步就翻译错了,之后的语义只会更错。所以我们会把「正确答案」告诉模型,保证它以正确的姿态去学习。到这里问题也来了——答案都告诉模型了,它直接照着看就行了,那还训练什么?所以我们在注意力中引入掩码,防止模型「偷看」,防止后文影响前文的预测。
6. 因果掩码注意力机制
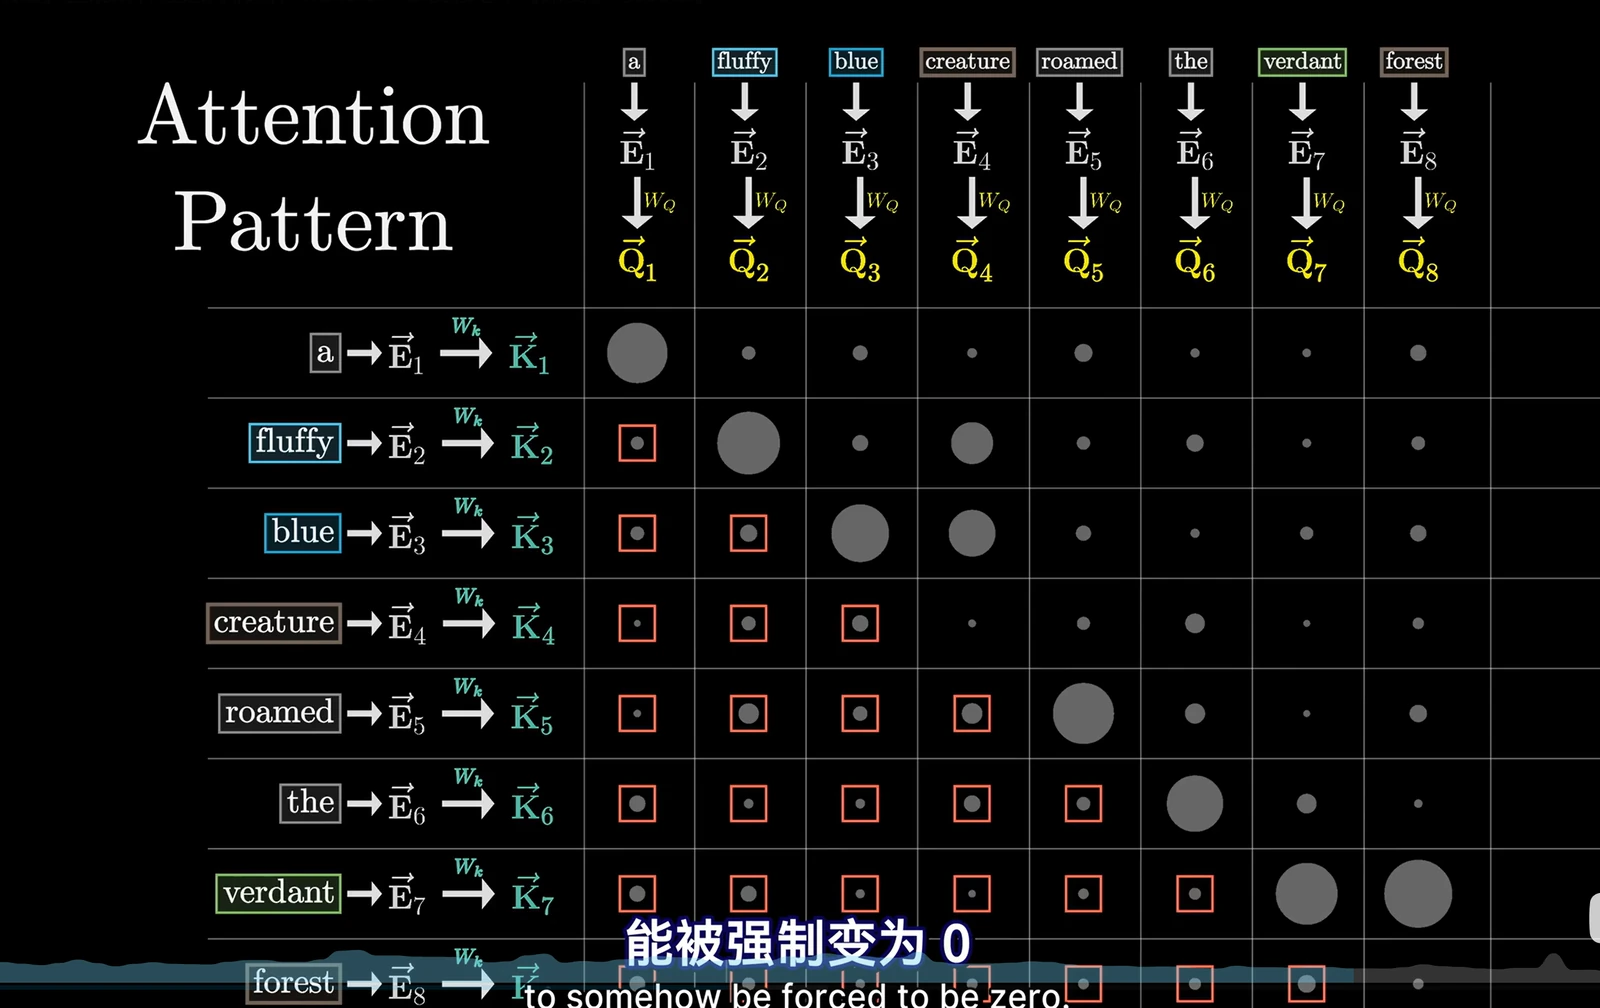
我们希望这个「询问」不要被后文影响;同时因为最后要输出概率,做法是先把后文置为负无穷,再经过 softmax 变成 0。
7. 前馈神经网络
一种网络结构:无循环、单向流动、多层,以全连接层为主。(RNN 循环神经网络不是;AlexNet 是。)这部分相对简单。
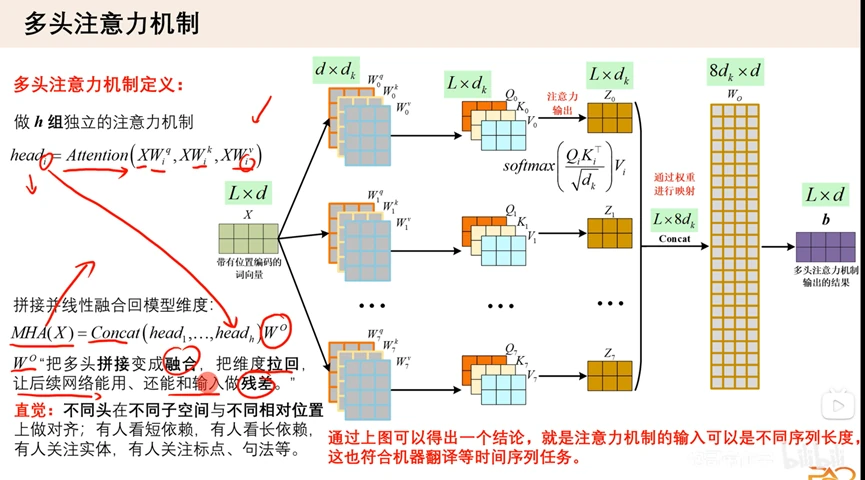
8. 多头注意力机制
针对一组 token,对每个 token 做多组独立的注意力计算。不同的注意力权重 W 关注的角度不同——比如句子中的意思、标点、句法等等。
9. 层归一化
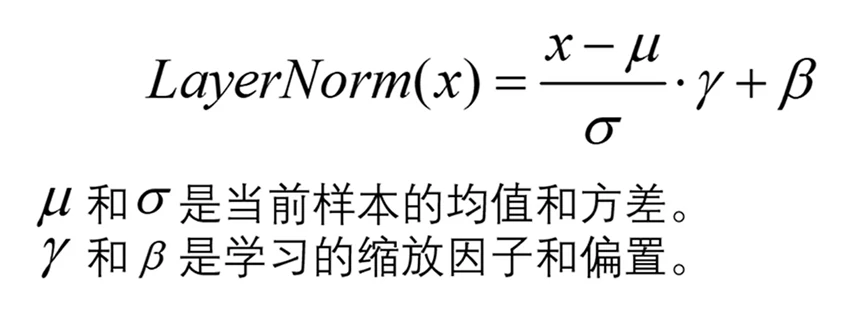
层归一化:对一个样本,把它在所有神经元上的输出一起归一化(y1, y2, y3, y4, …)。
批量归一化(ResNet 用的那种):在同一层里,对不同样本在同一个神经元上的输出做归一化(y1, y1, y1, y1, …)。
| 归一化方式 | 归一化的范围 | 典型场景 |
|---|---|---|
| 层归一化 LayerNorm | 一个样本,在全部神经元维度上的输出 | Transformer 的每个子层之后 |
| 批量归一化 BatchNorm | 同一神经元,在一个 batch 内不同样本上的输出 | ResNet 这类卷积网络 |
写在最后
我也是学习者,当时跟着 B 站的炮哥、3BB 的课程学。这篇文章是我对 Transformer 的学习理解,只是为了记录自己的学习过程和学习输出,可能存在片面和错误的地方,欢迎大家多多指正,共同学习。
文中的架构图、公式图和矩阵笔记截图来自课程课件,词向量空间的示意来自 炮哥带你学和3Blue1Brown 的注意力系列。