读 agent 源码容易陷在两个地方:要么被 CLI 那一层交互细节带跑,要么一直停在”LLM 会调用工具”这个结论上。把三个实现摆在一起看反而清爽——哪些零件是省不掉的,哪些只是实现风格,一比就出来了。
- CoreCoder:Python 手写的最小 agent。loop、tool、context 都从零写一遍,能看清骨架。
- Claude Code:生产实现,源码拆解在 xuanyuancode 上有完整连载。值得看的是启动装配、长期存在的会话对象、上下文工程,以及 BashTool 这类工具是怎么被”治理”起来的。
- learn-claude-code:教学实现。hook、task、多 agent、memory、MCP 被拆成小块逐个讲。
下面按机制整理,不按项目。
Agent Loop:整个流程的心脏
CoreCoder 用一个 for 循环撑起全部流程,max_rounds = 50,流转条件只有一个:这一轮还有没有 tool call。
工具调用遵循 OpenAI 的 function calling 范式:assistant 消息里带着 tool_call,每个调用有 id,执行结果按同样的 id 回到历史里,配对关系是 tool → tool_call_id → tool_content。骨架就这么点东西,真正麻烦的是循环里两个”不干净”的时刻。
第一,工具报错要能归因。 同一个 error,得先分清是参数传进 tool 函数时就错了,还是 tool 执行过程中才错的。前者是模型的锅(schema 或参数不对),后者是环境的锅(命令、路径、权限)。不分开,反馈给模型的提示就是错的,下一轮还会错。
第二,中断之后历史必须重新合法。 用户按下 Ctrl+C 时,如果恰好截断在”模型已经发出 tool_call、tool 还没执行完”的缝隙里,历史里就出现了一个没有结果的 tool_call。对模型来说这是非法状态,而且会影响整个会话。CoreCoder 的做法是给这个缺口补上 content: ["interrupt"],先把历史修回合法,再把异常往上抛交给上层处理。
这套”补一条合法内容”的思路后面还会再出现一次——上下文压缩的时候。
工具层:定义、编辑与执行
工具的定义很直白:继承 Tool 基类,持有 name、description、parameters,实现 execute(),再由 schema() 拼成 OpenAI function calling 的格式,注册进 tool_list。
真正要下功夫的是编辑文件的工具,因为它是 agent 最常用的那只手。三条路都试过:
- 让模型整体重写文件——太浪费 token。
- 让模型给行号去定位——模型对行号很模糊,而且行数改动不能有偏差。
- 让模型生成 unified diff(带
@@ -42,7 +42,8 @@那种行号头)——错误率高得让人头疼,那套上下文行数和偏移量它算不准。
于是 CoreCoder 选了第四条路:定位唯一修改内容。要求待替换的片段在文件里恰好出现一次;如果出现多次,就让它多带一段上下文,直到唯一;改完之后,tool 把这次修改的 diff 返回给模型,让模型自己判断改对没有。
Bash 这边是另一套纪律:每个命令执行前先过一遍 rm 之类的危险命令检测表;cd a && cd b 这种链式命令要按顺序理解,因为 b 是相对 a 的。
Claude Code 的 BashTool 则把这件事做成了系统能力。它的关键不在于”能执行命令”,而在于把命令执行构建成了一个拥有语义分类、权限约束、任务管理和 UI 呈现的正式能力:
- 它提供了验证代码所需的执行能力。 没有 BashTool,Agent 只能做静态修改;有了它才能跑测试(
pytest、cargo test)、看构建(npm run build)、调项目脚本(lint、格式化),以及和 Git、包管理器这些工具链打通,拿到完整的项目状态。从”看懂代码”到”验证代码”,中间隔着的就是这一层。 - 它尝试理解命令的语义,而不是黑盒执行。 区分一条命令是搜索、读取还是其他行为,而不是一股脑扔给 Shell。好处是三重:UI 呈现更合理(按命令类型给不同界面)、安全策略更精细(只读命令可以更放心地自动放行)、结果处理更好(搜索和读取的结果可以折叠显示)。
- 它有严格的安全控制。 一条命令进来,它会额外关心:是不是只读操作、操作路径是否合法、是否该放进沙箱执行、是否需要请求用户权限确认、是否适合放到后台跑。
补一句:CLI 里 agent 的实际输出和 UI 展示是两回事。展示层可以裁剪、折叠、上色,但那是展示层的事。
上下文工程:注入什么,砍掉什么
上下文分两件事:往里放什么,和往里砍什么。
注入。 CLAUDE.md 这类文件是核心——它是对仓库信息、项目分支、记忆信息等做过滤和去重之后得到的。它把项目经验从”靠人临时口述”变成了”可注入的系统知识”,这直接影响三件事:输出风格更稳定、修改更符合仓库约定、不容易反复犯同样的错误。除了它,git 状态也会一起进上下文。
压缩。 CoreCoder 准备了三档保障,一档不够用下一档:
tool_call的返回值只在当时那个任务上有用,后续任务里没什么可保留的,所以保留首尾、删掉中间。- 把历史消息压成摘要,但保留结构化内容,而不是变成一坨背景文本。
- 如果前两档还不够,就只保留最前面几轮加摘要,大幅删除。
这里有个坑,和开头那个中断问题同源:如果切分点恰好落在 tool_call 上,tool_id 和它的 tool_content 就被劈开了,历史又变得非法。所以删的时候要移动分割边界,不能从中间一刀切。
Claude Code 的顺序是同一个思路的延伸:优先保留结构化上下文,对低价值内容做压缩和裁剪,不急着把它变成一段摘要;不够就投影一个折叠后的上下文视图、让模型自主压缩;再不够才是兜底压缩。摘要不是第一步,是最后一步。
会话与状态:为什么需要 QueryEngine
main.tsx 是整个应用的”装配根”,它要抢在 REPL 起来之前把一切都准备好:
- 用 profile checkpoint 计算各阶段的初始化耗时,抢启动时间(加载配置、API)。
- 拉取 context、command、skill、tool,初始化外部能力(MCP、LSP),并搞清当前 session 的状态:是不是交互模式、有没有远程会话或桥接模式、要不要恢复旧会话、模型 / 权限 / 提示风格 / 工作目录分别是什么。
- 这些都在 REPL 启动前完成——用户看到界面的时候,能用的东西已经就位。
QueryEngine 是一个围绕会话长期存在的对象,这就是它能跨多轮次的原因。它长期持有的状态,也正好就是”一次会话结束之后还留下来”的东西:
- 消息历史
- 已知的权限拒绝信息
- 文件读取缓存
- usage 统计
- 某些 memory / skill 的发现状态
submitMessage() 本质上就是”启动一轮 agent run”:接收用户输入 → 设置目录和 session → 过滤 tool → 配置 prompt 和上下文 → 开启 query 与模型交互 → 工具调用输出并追加 history → 统计 usage 和状态。串起来就是这些,没有别的魔法。
为什么它有反思和纠错能力? 因为不是简单地”模型调用工具”,而是工具结果的回流:模型根据 system_prompt / history 做决策 → 决策里可能包含 tools → tools 走权限判断 → 模型调用 tool 拿到结果 → 结果注入 history → 进入下一轮。模型每轮看到的都是上一轮的真实结果,纠错能力是从这个回路里长出来的,不是额外加的功能。
并发:并行工具与子 Agent
Claude Code 在解析用户输入的时候,tools 已经在执行了,不必等整段响应结束,所以回复快;CoreCoder 则是老老实实按顺序执行。差别不在”谁更先进”,而在要不要为这点延迟付出复杂度。
CoreCoder 的取舍是:一个任务如果有多个 tool 响应,单个就直接跑,多个就交给 _exec_tools_parallel,也就是一个线程池。但并行不是肆无忌惮的——
线程 1 正在保存 A 目录,线程 2 并行保存 B,回头再看 A 的内容就被覆盖了。
所以线程之间必须隔离。Python 里有现成的工具:threading.local(),它给每个线程一份独立的副本,线程之间互不可见。
子 Agent 的处理更值得看。 CoreCoder 里没有显式定义”子 agent”这个实体,而是通过 AgentTool 定义:AgentTool 指回主 agent,子 agent 与主 agent 共享资源;同时给子 agent 单独开一份 context,让主 agent 的窗口保持干净——主 agent 不需要知道子 agent 中间干了什么,只要它的执行结果。唯一的约束是:子 agent 不能再调用 AgentTool,否则就是无限套娃。
learn-claude-code 把这条边界画得更清楚:
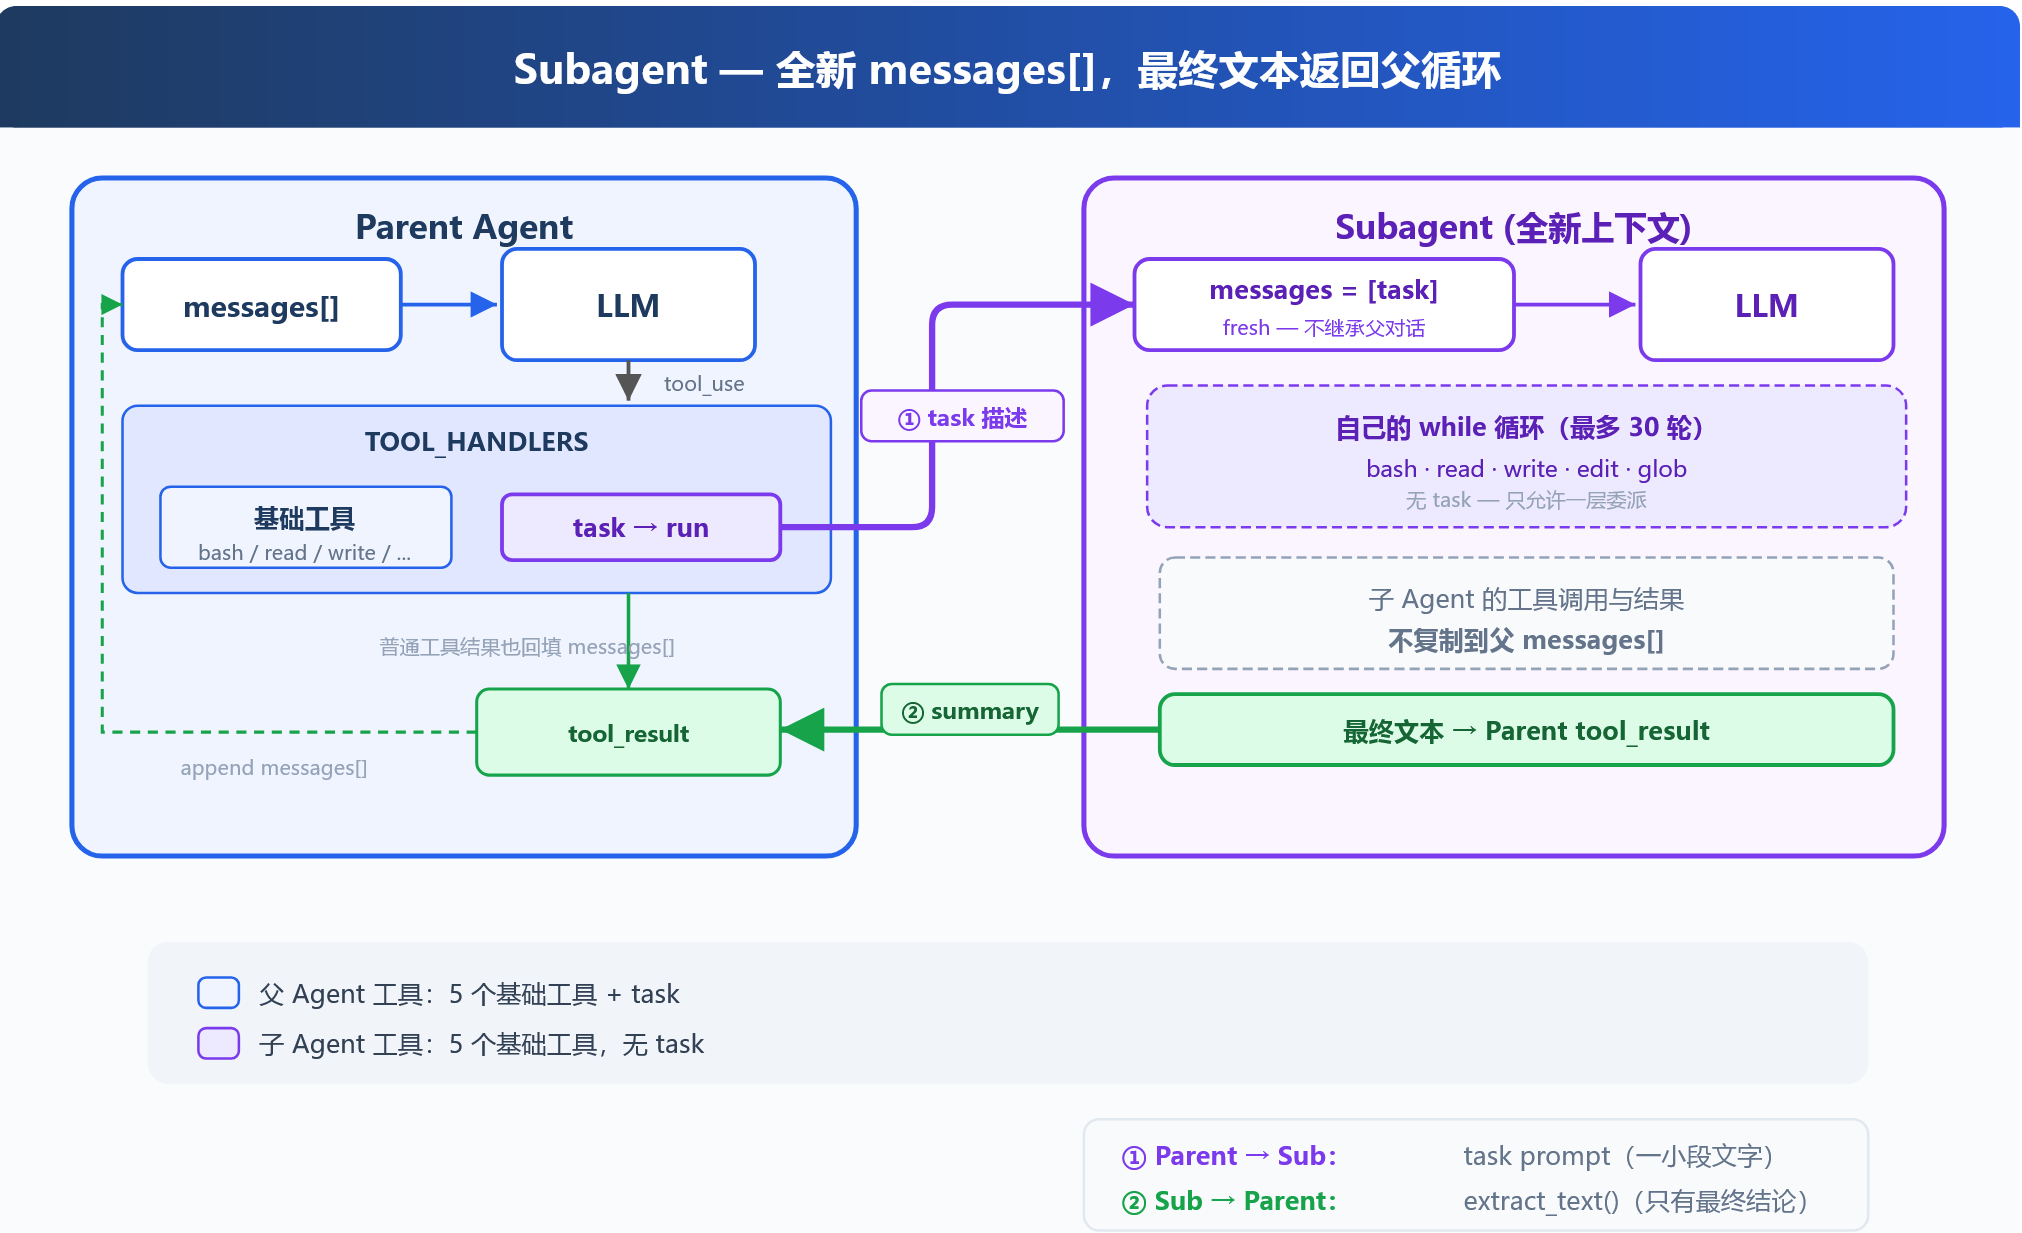
- 子 Agent 拿到的是全新的
messages[],fresh,不继承父对话。 - 它跑自己的
while循环,最多 30 轮,工具表是 bash / read / write / edit / glob 这些基础工具,没有 task——只允许一层委派。 - 它内部的工具调用和结果不复制回父
messages[],只有最终文本通过类似extract_text()的方式,作为父 Agent 的tool_result回去。
来回一算:父 Agent 的窗口里只多了”一小段任务描述”和”一段结论”。
扩展点:Hook 与任务系统
Hook 写在 loop 外面。 如果扩展逻辑一行行塞进循环,它很快就会变得认不出来:
def agent_loop(messages): while True: # ... LLM call ... for block in response.content: if block.type != "tool_use": continue log_to_file(block) # 加一行 check_permission(block) # 加一行 notify_slack(block) # 又加一行 output = execute(block) auto_git_add(block) # 再加一行 # ... 很快循环就认不出来了于是有了 HOOK 表:UserPromptSubmit(上下文注入)、PreToolUse(权限、日志)、PostToolUse(大输出处理)、Stop…… 覆盖三类诉求——对 tool 的权限(用户许可、高危命令)、对 tool 工作日志的打印、对 tool 输出的判断(是不是大文件)。
关键在于:执行顺序本来可以一样,Hook 的价值不是改变顺序,而是把具体扩展逻辑从 Agent Loop 里解耦出来,让扩展可以独立注册、增加、删除,而不用动核心 loop。
Todo 和 Task 是两件事。 如果说 todo_write 是告诉你 agent”要做什么”,task_system 就是告诉你任务之间的依赖。
Todo 是一个列表:它让 Agent 具备规划能力,但不是所有的任务都需要 todo。状态用 [ ] pending、[>] in progress、[x] completed 表示。
Task 是持久化文件。像”创建 db → 创建表 → 测试”这种任务,整体有先后依赖:
# 创建任务依赖,通过 blockedBy 去连接# 一个任务一个文件,跨会话保存 / 可恢复@dataclassclass Task: id: str subject: str description: str status: str # pending | in_progress | completed owner: str | None # 负责当前任务的 Agent blockedBy: list[str] # 依赖的任务 ID 列表规则有两条:一个 task 一个文件(.task/<task_id>.json);只有当 blockedBy 里的任务(first 除外)全部 status=complete,下一个才能开始。状态从 pending 走到 in_progress,再到 completed。
这也顺带回答了”如果退出 CC,任务还存在吗”——在,因为它是磁盘上的文件,不是内存里的变量。
多 Agent:Agent Team
Subagent 像 tool 一样,执行完就结束;Agent_team 则要保持持续状态(work、IDLE、shutdown)。这部分是三个实现里最”工程”的一块,值得逐条记:
- 要不要用多 agent,由用户判断。 lead 会提出方案,用户决策。
- 分配靠文件不靠抢。 一个 task 一个文件(也有
lead.json),里面owner = agent,任务可以直接指派,不用争抢。 - 任务分配是双向的。 初期由 lead 分配 agent_task;但 agent 执行完之后还有剩余任务(现实中 task 数远大于 agent 数),加上 lead 自己的回顾任务,于是空闲的 agent 会去接新任务(
new_task > lead_task)。 - 消息走持久化 mailbox。 agent 之间、lead 之间通过
.mailboxes/<agent>.json传递信息。
# Mailbox 为 agent 之间通信,.mailboxes/# 一个 agent 一个 .json 文件,记录的是发送给 agent 的消息# agent 之间有独立的 context / loop / tool / messagesclass MessageBus: def send(self, from_agent, to_agent, content, msg_type="message", metadata=None): msg = { "from": from_agent, "to": to_agent, "content": content, "type": msg_type, "metadata": metadata or {}, } ...- 反馈要清理。 agent 执行完把 result / status 反馈给 lead,同时
clear_lead;不清理的话,下一次还会把 agent_team 的旧信息重复注入一遍。 - 并行要隔离文件。 agent_team 是并行执行的,为防止相互干扰地改同一份内容,会在目录下建
worktree分支(.git/worktree)。 - 可观测,才谈得上可执行。 Runtime 通过暴露 args 展示 agent 是不是真的在”做”,而不只是接受了请求。
- 一个 agent 一个线程。 创建 thread,每个 agent 一条自己的 loop,执行
(task, name)。
长期能力:记忆、MCP、后台任务、定时任务
memory
记忆要解决四件事,每件都有对应的机制:
存储——怎么持久化? 一个记忆一个文件,放在 .memory/ 下分门别类(personal_prefer、project……),字段包含 name / description / type / content;另外放一份 .memory/MEMORY.md 记录每个记忆的摘要,一行一个,充当索引。
召回——怎么放进对话? 分四步递进:先拿最近几轮对话做反馈;再用一个小模型对用户输入和 MEMORY.md 做语义匹配,拿到 index;匹配失败就把用户输入正则化拆成关键词,去匹配 memory 的 name、description;最后,记忆是作为背景知识加入的——当前请求优先于历史记忆,是”优先考虑”,不是覆盖。
提取——怎么从上下文里提取? 让 LLM 把用户输入解析成 json 去匹配 memory,只有 scope=persistent 才存入;兜底用 temporary memory 词表判断;字段缺失同样不允许入库。
整理——怎么优化记忆? 记忆数量到达阈值时重新整理知识;处理重复记忆时对比 name、description、body 等字段;改动前先存原文件快照,改或删失败还能恢复(先 snapshot,再改)。
MCP
链路是三层:mcp server(拿到 tool 的地方)→ mcp client(用 handler 执行 tool)→ harness。
- tool_pool 是动态的。 第一轮只有基础 tool;连接 mcp server 拿到相应 tool 之后,第二轮用
assemble_tool_pool()组装,Tool = 基础 tool + mcp_client_tool。 - 为什么命名成
mcp__{server}__{tool}? 因为不同的 server 可能有同名 tool,加上 server 前缀才不会撞。 - 权限要收口。 如果某个 mcp server 提供了
delete_database、trigger_deploy这种本质很危险的能力,必须由 harness 或用户做最终确认。
后台任务
思路一句话:让 Agent 启动一个耗时任务之后不要傻等——把任务扔到后台,Agent 继续思考和干活,等任务完成再把结果告诉它。
- 目前只对 bash 开放:tool_call 的返回里带有
{"name": …, "run_in_background": …},只有当tool_name == "bash"且run_in_background为真时才走后台执行,这个判断依赖 LLM 的语义理解。 - 因此一个 tool 会有两个 tool_call:主线程
bash → bg_id,后台bash → command。后台结果会被格式化成一个<task_notification>,告诉 LLM 这是一件新的独立事件。 - 加锁(
threading.Lock)之外,还有个细节:任务完成后不会立刻插进 agent loop,而是先放进result{}/_ready[],等下一个 loop 再消费。
Cron scheduler
定时任务,比如让 agent 每天推送一次。机制比想象的土:每秒更新时间,和任务时间比较,到点就把任务放进 cron.queue,等 agent 空闲时再交付到 message 里;用锁避免线程争用。有 first 触发:first 放入队列,后期不再重复存入。
# durable=True 写成 json,可跨会话保留 / 任务重启保存@dataclassclass CronJob: id: str cron: str prompt: str recurring: bool durable: bool pending_delivery: bool = False last_fired: str | None = None# cron 决定何时触发,prompt 是触发后交给 Agent 的任务。# pending_delivery 表示任务已经到期但尚未被模型接收,# last_fired 防止同一分钟重复入队。安全边界
前面零散提过几处安全设计,这里集中收一下。CoreCoder 的 /save 是个好例子:保存会话要让用户输入会话名,但在命令行上就是敲任意字符,什么都不防。
第一道防线是清洗。 直接取末尾的名字,防止它跳去别的目录:
输入: session_id = "../../etc/passwd"
清洗:  replace("\\", "/")   -> "../../etc/passwd"  split("/")[-1]       -> "passwd"  正则替换              -> "passwd"  strip("._")          -> "passwd"  返回 "passwd"
拼接: /home/user/myapp/sessions/passwd.json检查: 父目录是 /home/user/myapp/sessions,通过
第二道防线是校验。 万一绕过了清洗,resolve() 之后还要比一次父目录:
拼接: Path("/home/user/myapp/sessions/../../../etc/passwd.json")解析: resolve() -> /etc/passwd.json检查: path.parent 是 /etc,不等于 root(/home/user/myapp/sessions)结果: 立刻抛出 ValueError("Invalid session id"),阻止访问这两道加上前面的 Bash 危险命令检测表、MCP 危险工具的最终确认,原则是一致的:不要指望模型自觉,把危险收敛在边界上,让越界在代码层面直接不可能。
读完这三点
把三个实现放一起,能落下来的判断大概三条:
Loop 本身最简单,难的是循环里那些”不干净”的时刻。 中断、报错、压缩、并发——每一个都会让历史或状态变得不合法,而处理它们的套路出奇一致:先让数据重新合法,再谈别的。content: ["interrupt"]、移动压缩的切分边界、线程各持一份副本,都是同一个动作。
上下文是资源,压缩不是事后补救。 它决定了压缩时该砍哪里、该留什么。所以”保留结构化内容”排在”变成摘要”之前——摘要不可逆,裁剪可逆。
Agent 的能力边界靠外部系统撑起来。 task 文件、mailbox、worktree、memory 目录、cron 队列,这些东西放在一起看挺土的,但正是它们决定了 agent 能不能跨会话、能不能协作、能不能被观测。模型之外的这一层,才是工程真正要写的地方。